Hay que decir que no soy demasiado ordenado al presentar nuevas tecnologías ya que primero de todo
hice un benchmark sobre Gearman
antes de hacer una introducción; pues bien, como en este artículo quiero hablar sobre unas posibles extensiones sobre las que quiero trabajar con Gearman, primero de todo haré una pequeña introducción al proyecto.
Introducción
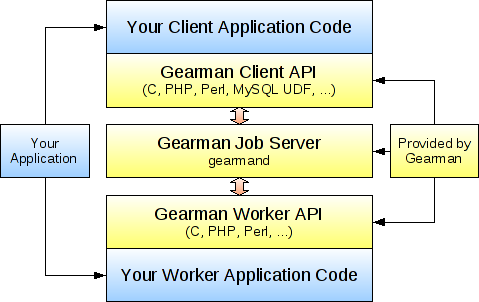
es lo que comúnmente llamamos un servidor de tareas, o sea, que cuando nuestro código tiene que pedir una tarea, funcionalidad, trabajo, o algo similar es muy interesante de cara a:
- la escalabilidad: podemos tener tantos servidores y/o procesos consumiendo tareas como nos interese.
- paralelismo: las tareas se pueden consumir paralelamente.
- balanceo de carga: podemos hacer map/reduce sobre las tareas y enviarlas a los servidores que nos interesen para distribuir la carga.
- independencia entre lenguajes: el código que pide la tarea y el que consume la tarea pueden ser totalmente diferentes; las librerías que tiene Gearman son: PHP, Pearl, Ruby, C, Python, etc.
- interfaz HTTP: además dispone de una interfaz cliente HTTP que nos permitirá inyectar tareas desde lenguajes no soportados desde las librerías de Gearman.
usar un servidor de este tipo, ya que además de permitirnos pedir tareas síncronas, también podemos pedirle tareas asíncronas. O sea, que no solo no sabemos quién nos está haciendo el trabajo limitándonos a recibir el resultado sino que también podemos pedir que este trabajo se haga cuando se pueda.
Por si todo esto no fuera poco todavía hay más ventajas:
- Open Source
- Programat en C
- Petit i molt ràpid
- Soporta varios backends: RAM, SQLite, Memcached, Tokyo Cabinet, etc.
La gente que empezó a implementar Gearman fueron los de
famosos por
i
.
Mis ideas
Después de esta introducción, ahora ya puedo hablar de las cosas que me gustaría que hiciera Gearman pero que no hace. Primero de todo tengo que hablar de las ventajas que tendría si pudiera tener un backend contra Redis. Lo que persigo al conectar Redis con Gearman es conseguir:
- persistencia de tareas aunque se reinicie Gearman
- persistencia de tareas en disco aunque se reinicie Redis, gracias a:
- la escritura asíncrona a disco
- bgrewriteaof: evita que por la escritura asíncrona de información se pierdan datos al reiniciar bruscamente Redis
- publicar en un canal PubSub de Redis los cambios que se hacen sobre una tarea que se ha enviado a 'background'
Integración con Redis
Se trata de hacer lo mismo que se hizo para integrar el backend de tokyo cabinet:
el problema de usar tokyo cabinet contra disco es la pérdida brutal de rendimiento respecto a usarlo contra RAM, ya que las escrituras se hacen de forma síncrona.
A nivel de código las similitudes más grandes son con:
, aunque el problema que tiene esta implementación es que cada vez que reiniciamos memcached no tenemos persistencia de la información que se había guardado en memcached, es como si las claves que se habían introducido en la anterior sesión se hubieran borrado. Además memcached tampoco soporta persistencia en sus datos.
Así pues, lo que hay que hacer es coger lo mejor de ambas integraciones y hacer el módulo con Redis.
Suscripción a las actualizaciones de una tarea vía Redis
Cuando se envía una tarea en segundo plano a Gearman este nos devuelve un 'Handler' para poder preguntar sobre el estado de la tarea; el problema es que si queremos saber cómo evoluciona la tarea o que nos informe cuando ha acabado no hay manera de saberlo si no es haciendo 'pooling'. Por otro lado, el 'worker' va actualizando la tarea cada vez que lo cree conveniente para que Gearman pueda saber cuál es el estado de la misma.
Mi idea es que al usar el backend de Redis, en el mismo momento en que se actualice el estado de la tarea también se publique (publish) en un canal
de forma que el código que ha enviado la tarea pueda suscribirse (subscribe) a este canal y en tiempo real y con un coste de recursos bajísimo se pueda seguir el estado de la tarea. Esto nos evitaría la necesidad de que Gearman tuviera que poder llamar un método de callback para informarnos del estado de la misma, ya que hay algunos lenguajes en los que hacer esto no es tan sencillo.
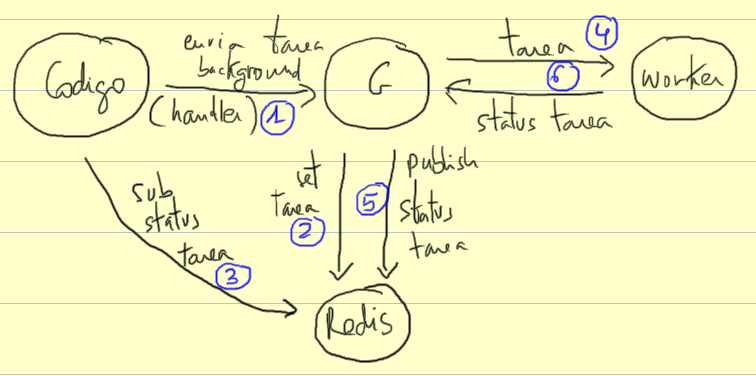
En el gráfico que adjunto a continuación podemos ver un esquema que he hecho sobre esto:
-
nuestro código envía una tarea en 'background' (segundo plano) a Gearman y este le devuelve un 'Handler' para identificar la tarea.
-
se guarda la tarea en Redis (set)
-
nuestro código se suscribe al canal PubSub de la tarea
-
un worker pide la tarea
-
se publica el estado de la tarea
-
se va actualizando el estado de la tarea
-
se van repitiendo los puntos (5) y (6) hasta acabar la tarea
Feedback
Como siempre se aceptan todo tipo de críticas e ideas sobre mi 'paranoia'.